Ломается таблица каналов
ИсправленоАвтор: smiledjВерсия: 1.0.0 rc1720.10.2026
Материал: UV990 Studio
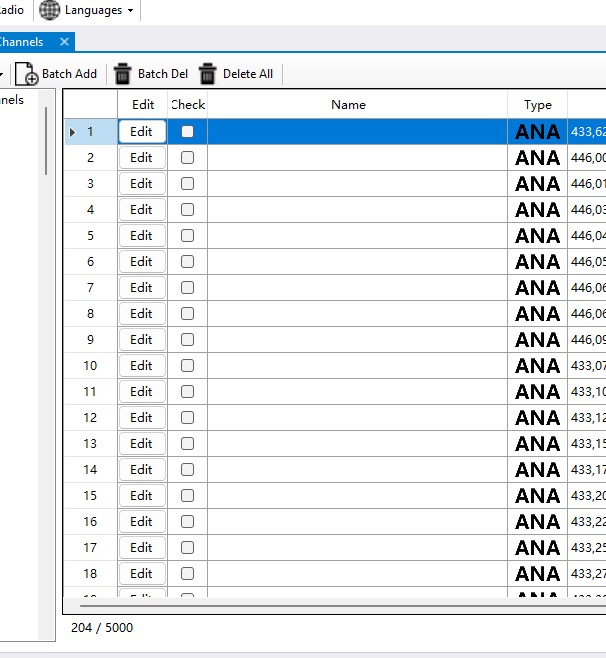
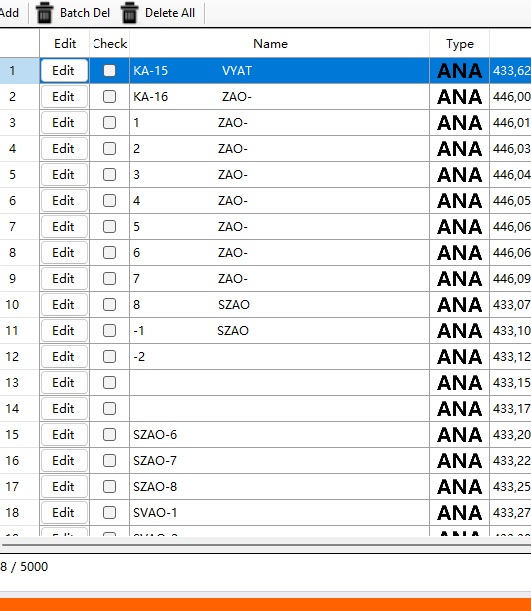
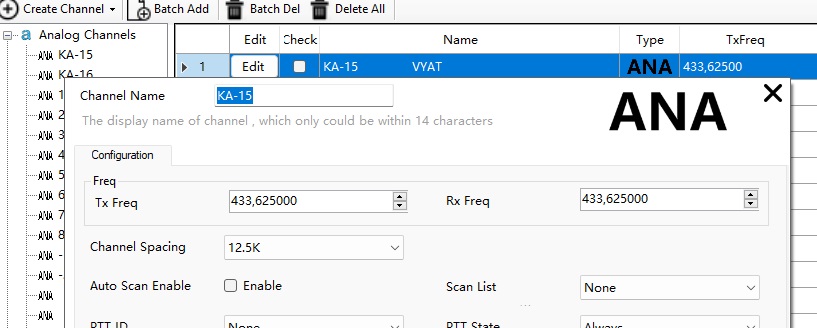
После записи кодпалага через студию в станцию, происходит корректное чтение родным софтом, но после записи кодплага с родного софта в станцию, он перестает читаться Студией и в родном софте исчезают названия каналов.
При этом если предварительно НЕ записывать кодлплаг студией, а только записать с родного софта, то в студии чтение происходит без ошибки.
При попытке открыть файл CPS, который был записан из студии, прочитан в родной CPS и сохранен, выходит ошибка "Неподдерживаемая разреженная таблица каналов"
Исправлено в версии rc20
Скриншоты
Диагностические логи
Содержимое этих логов опубликовано автором обращения.
bugfix.txt
Итоговый список правок: код + место

Файл accps.py

1. В начале файла, после существующих импортов — функция _dbg (опционально)
Было: импорты import struct, re, os, tempfile, csv, затем class FormatError / @dataclass Module.
Добавить:

import datetime as _dt

def _dbg(*args):
    try:
        here = os.path.dirname(os.path.abspath(__file__))
        base = here; log = None
        for _ in range(6):
            cand = os.path.join(base, "save")
            if os.path.isdir(cand):
                log = os.path.join(cand, "backend-error.log"); break
            base = os.path.dirname(base)
        if log is None:
            log = os.path.join(here, "accps_debug.log")
        with open(log, "a", encoding="utf-8") as f:
            f.write(_dt.datetime.now().strftime("%Y-%m-%d %H:%M:%S") + " [accps] "
                    + " ".join(str(a) for a in args) + "n")
    except Exception:
        pass

2. __init__ — добавить параметр repair
Было:

    def __init__(self, data: bytes):
        self.original = bytes(data)
        self.data = bytearray(data)
        self.modules = {}
        self._parse()
Стало:

    def __init__(self, data: bytes, repair: bool = False):
        self.original = bytes(data)
        self.data = bytearray(data)
        self.modules = {}
        self._parse(repair=repair)

3. _parse — сигнатура + фильтр 0xFFFF
Было:

    def _parse(self):
        ...
        ids=[self.u16(self.ch_start+i*64) for i in range(self.count)]
        if any(i>=self.capacity for i in ids) or len(set(ids))!=len(ids): raise FormatError(tr('Неподдерживаемая разреженная таблица каналов.'))
        ...
Стало:

    def _parse(self, repair: bool = False):
        ...
        ids=[self.u16(self.ch_start+i*64) for i in range(self.count)]
        if not repair:
            real = [i for i in ids if i != 0xFFFF]
            if any(i>=self.capacity for i in real) or len(set(real))!=len(real):
                raise FormatError(tr('Неподдерживаемая разреженная таблица каналов.'))
        ...

4. Новый @classmethod open_repair — рядом с open
Добавить после существующего open:

    @classmethod
    def open_repair(cls, path):
        cp = cls(Path(path).read_bytes(), repair=True)
        changed = cp.renumber_channels()
        return cp, changed

5. Новый метод renumber_channels — внутри класса (например, перед save_copy)

    def renumber_channels(self):
        n = self.count
        patch = bytearray(self.data)
        mapping = {}
        changed = 0
        for row in range(n):
            at = self.ch_start + row * 64
            old_idx = self.u16(at)
            if old_idx == 0xFFFF:
                continue
            mapping[old_idx] = row
            if old_idx != row:
                struct.pack_into('
Что чинить: индекс канала vs номер строки
Ключ к разгадке — ваш второй симптом
«При удалении каналов рано или поздно на разных каналах появляются имена, но не те» — это уже не догадка, а прямое доказательство механизма.
Если бы имена просто терялись, это была бы одна история. Но они появляются снова, съезжая по каналам — значит:
имена в файле есть;
программа B читает их не там, где ожидает, и находит старые ячейки от предыдущих операций;
при удалении (сдвиге записей) новая раскладка случайно совпадает с какой-то из старых позиций → «всплывает» чужое имя.
Это классическая рассогласовка record.index ↔ row (номер слота в записи ↔ порядковый номер строки).
Механизм в двух формулах
В 64-байтовой записи канала:
text
[0..1] = channel index (слот 0..4999)
[2..63] = поля канала
В отдельной таблице имён (после 5000*64):
text
names[K] = имя канала, у которого ??? == K
Есть две возможные трактовки K:
Reader/writer Что пишет/читает
ROW-based names[номер_строки] — 0,1,2,… подряд
INDEX-based names[channel.index] — по значению в поле [0..1]
Программа A (ваш accps.py) — ROW-based (см. self.names_start + row*18 в channel(), update_channel(), clone_channel()). Это нормально.
Программа B — рассогласована:
reader смотрит по channel.index (или наоборот — writer по row, reader по index);
writer пишет по row.
До тех пор пока index == row — оба варианта дают одинаковый результат, всё работает. Как только они расходятся (спарсенный файл), начинается ад.
Откуда у вас расхождение index != row
Прямо в accps.py, clone_channel:
python
ids={x['index'] for x in self.channels()}
idx=next(i for i in range(self.capacity) if i not in ids) # ← вот оно
struct.pack_into('